256G 统一内存,我这样安排本地模型
杂货铺 · 第053篇
欢迎来到我的小铺,今天聊聊本地模型。
先说个数。过去这段时间,我本地模型累计处理了70亿 token。不是70万,是70亿。
这个数摆出来,不是为了证明我多能折腾。它想说明的是一件更朴素的事:本地模型已经是我的主力在使用了。
昨天把整个环境摊开说了一遍,从 Mac mini 到 NAS,从算力到存储。今天开始聊积木,一块一块拆。第一块,就是本地模型。
一、256G 这堵墙
聊本地模型,绕不开内存。
我手上两台DGX Spark,统一内存加起来 256G。这个数放在消费级里算宽裕,放到大模型面前,就成了一堵实实在在的墙。
墙在哪?拿 GLM 5.3 满血版来说。它是 744B 参数,MoE 架构,每次推理激活 40B。40B 听起来不大,很多人会以为“激活小就等于跑得动”。这是个错觉。激活参数决定的是每次计算量,可 744B 的完整权重,一个字节都省不掉,必须全部塞进内存。
按 INT4 量化估算,光权重就要约 372GB。再加上 KV 缓存、激活开销,实际需求 400GB 往上。256G 装不下,这是硬约束,不是优化能绕过去的。
不过这里有个容易想岔的地方。就算把模型压到 160GB 上下,看着 256G 还富裕出近百 G,好像绰绰有余。真跑起来不是这么回事。
那近百 G 要同时装好几样东西,其中最大的一块叫 KV 缓存。模型每读一个字,都要把它在每一层里的中间状态留下来,后面生成时才不用重算,这份“记忆”就是 KV 缓存。它的大小跟两件事成正比:喂进去的上下文有多长,同时开几路会话。 上下文翻一倍,它翻一倍;同时开三路,它再乘三。材料很长、又同时跑几个任务的时候,它能把剩下的空间一点点吃掉。
所以“160GB 权重”这四个字,只说了故事的一小半。权重是死的,一装上去就那么多;KV 缓存是活的,跟着怎么用往上涨。把它压进 256G,真正的余额,是那 96G 减去打算喂多长的材料、开几路会话之后剩下的那点。
我当前的双机方案,跑起来之后,日志里显示能用的 KV 缓存是 17 GiB 出头,换算成 token 大概是 233 万个。听着很多,可这是所有会话共用一个池子。也就是说,单路开满 100 万 token 的请求,同时只能跑两个多一点。
1M 上下文是个天花板,不是一个给你预留好的空房间。
所以本地选模型,第一个要问的,是“256G 里塞得下什么,塞下之后还能不能干活”。
二、两个模型,不是替代,是分工
在这个约束下,我最终留了两个模型在本地。使用的是Mia's AI Lab 的双机方案,这是我当前测试最好用的本地部署方案,双DGX Spark只当服务器,通过API的形式来调用算力。
一个是 DeepSeek V4-Flash 0731。284B 参数,激活 13B,量化后权重约 160GB,纯文本,速度快。它是 DeepSeek 2026 年 7 月 31 日发的正式版推理模型,MIT 协议,权重里路由专家用 FP4、非专家层用 FP8,光模型体积就有约 167GB。跑起来是个干脆的性子,问它什么,答得又快又稳(不像后面出的4.1和Qwen3.8 Flash,雷霆大思考),拿它写文本、改稿子最顺手。它的定位很清楚:要快、要写文本的时候用它。我到现在有些需要写文本的场合,还是会直接换上它,因为它比 GLM 5.3 Flash 要快一点,并发效率要高一点。单流带思考输出,大概每秒40~60token;编码这类任务,能冲到80+,4并发的时候基本能稳定在110+ token
这里还有个提速的邪道,叫推测解码。说白了就是先让一个小模型拟一小段草稿,再交给主模型核验,通过的部分一起收下,没通过的再改。草稿拟得越准,省下的逐步计算就越多。DeepSeek 这套跑法用的是DSpark 方案。模型本身的能力是一半,怎么把它跑起来,是另一半。
另一个是 GLM-5.3-Flash-EXL3,现在的主力。320B 参数,激活 18B,4bit 量化后约 160GB,原生多模态。
为什么会有第二个?原因只有一个,DeepSeek不认图。
这一点很要命。不认图,就得给它套一个外部的识图模型。图先传出去识别,结果再送回来。这一进一出,就违背了我用本地模型数据不出本地的初衷。
GLM 5.3 Flash 把这个问题解决了。它原生就能看图,图不用出门。而且用得越久,我越觉得它在主观能动性这些方面,有时候甚至比GLM 5.3还好一些。不是参数大就一定好用,模型和任务对不对得上,比纸面数字重要。
当然这一开始也并不顺利,5.3 Flash刚在我这儿跑起来的时候,写散文每秒不到20 token,这个速度和之前一比差了一倍不止。我一度还是拿 DeepSeek 当主力。后来换了更合适的量化权重,又用上 TensorFold 这套推理方案,情况才翻过来。
这里说的量化权重,是社区做好的 EXL3 4bpw 版本。量化说白了就是把权重用更低的位宽存下来,体积和内存一下就小一截,代价是精度有一点损失。GLM 满血 320GB的体量,压到 4bit 之后大概 160GB,两台 Spark 刚好装得下。
EXL3 是一种新的压缩方式。以往的量化是给所有权重套同一个刻度,一刀切下去,好压的坏压的全按一个标准来,精度就掉得厉害。EXL3 换个思路:它先把那些不好压的权重分布“摊平”、抹匀,让它们变得好处理,再用一套专门的编码方式成组地存。用大白话说,就是先整理再压缩,而不是硬塞。这么绕一圈,是为了在压到很低位宽的同时,尽量不伤模型原来的能力。
而TensorFold也是一个最新的技术,它负责把推理组织起来,计算怎么排、缓存怎么用、两台机器怎么配合,都归它管。量化让它装得下,推理优化让它跑得顺,这两件事凑齐,我才真正愿意切成GLM。现在单次任务能跑到每秒40+,有些还能过六十。从20不到优化至这个数,等同一篇文章、同一份方案的差别是能感觉出来的。当然,材料特别长、或者同时开好几个任务,还是会慢下来。
所以这两个模型在我这儿是分工。一个管快、管纯文本,一个管多模态、管主力。256G 的空间里,我买的不是“最强”,是“刚好够用又各司其职”。
三、跑得起来不算数,我真正看的是三样
市面上的评测,大多在回答一个问题:能不能跑起来,跑分多少,超没超过谁。
但如果真的要纳入工作流,跑得起来只是入场券。同样跑得起来的两台机器,1 秒出几个字和 1 秒出几十个字,是两个物种。
我真正看三样:读取速度、出字速度、上下文长度。
第一个是读取速度。给它一份材料,它要多长时间才能“读完”、开始动手。这个在 Agent 场景里比什么都吃紧。Agent 连着几十步往下走,每一步都得把上下文重新过一遍。读得慢,整套流程就卡在那里。
我这两台机器,读材料的速度,两万字的材料十几秒就能过完,一本八万字的短书,一分钟左右。这个量级意味着,我把一堆参考和记录甩进去,起身倒杯水的工夫,它就能开始跟我讨论了。慢一点的机器不是这个节奏,泡杯茶的工夫它还在读。
第二个是出字速度,也就是输出速度。这一条直接决定体感。太慢的话,我跟它说话就像在等传真机。快与不快,决定的是我愿不愿意用它,而不是它厉不厉害。前面报过的那两个数,说的就是它俩往外蹦字的速度。换算成中文,大概每秒吐40+个字,比一般人打字快,离一目十行还差得远。
第三个是上下文长度。这一条最近格外有感触。
昨天 GPT 6.1 Sol 更新,默认上下文从 272K 提到了 500K,差不多翻了一倍。为什么提?因为 200 多 K 在 Agent 场景下,非常容易就撞到上限。撞到了就得压缩、切块,对内容的理解就会有损失。OpenAI 这一提,等于侧面承认了一件事:在 Agent 语境里,200 多 K 已经不够用了。
GPT 6.1 Sol 扩容后是 500K。我本地这两个模型都是 1M,还是它的两倍。
我本地不用操心这事。1M 上下文,一整本书丢进去接着问,不用压缩,不用来回切。说到这里,其实很多时候就是以量取胜。上下文给得足,很多本来要靠技巧解决的问题,直接就不存在了。
四、我让它盖了间便利店
光说速度,还是虚。为了这篇文章,我拿一个具体的开发场景做了次测试。
要求是一个雨夜的便利店,能在浏览器里打开,可以旋转、放大查看。店面、街道、雨、灯光,还有店里和门口的一些细节,都要做出来。
同一个要求,分别交给本地 GLM 5.3 Flash、智谱线上的 GLM 5.3 Flash,和 Kimi K3,都放进 Kimi Code 的环境里跑。
三个都做出了东西,但过程和最后的样子,差别还挺明显。
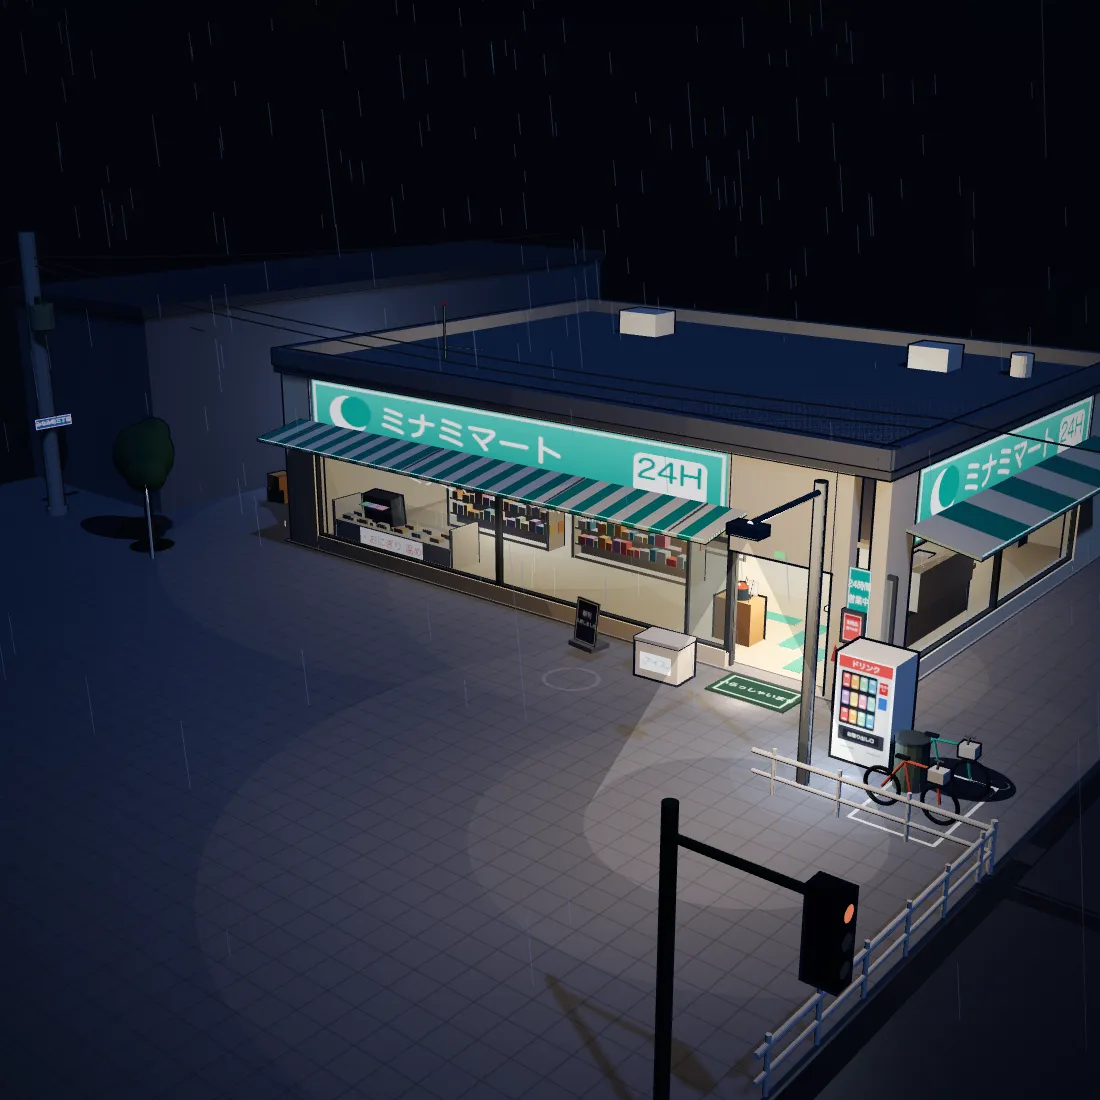
本地这一份,是三个里最慢的,一共跑了约50分钟。刚打开时,画面偏暗,相较于其他两个相对简单。但空间关系基本正确,它在浏览器里看截图,改灯光、改招牌、挪物体,再打开检查,来回调了好几轮。
中间有个细节挺有意思:店内的灯光“穿”到了屋顶上,留下几块不该出现的光斑。它换角度、放大看,查了几轮,才把这个问题修掉。信号灯、自行车、门口的积水,也都陆续调整过。
这些东西,只看代码有没有报错,是看不出来的。要把页面打开,看到实际画面,才能知道下一步该改什么,这就是有视觉的好处。
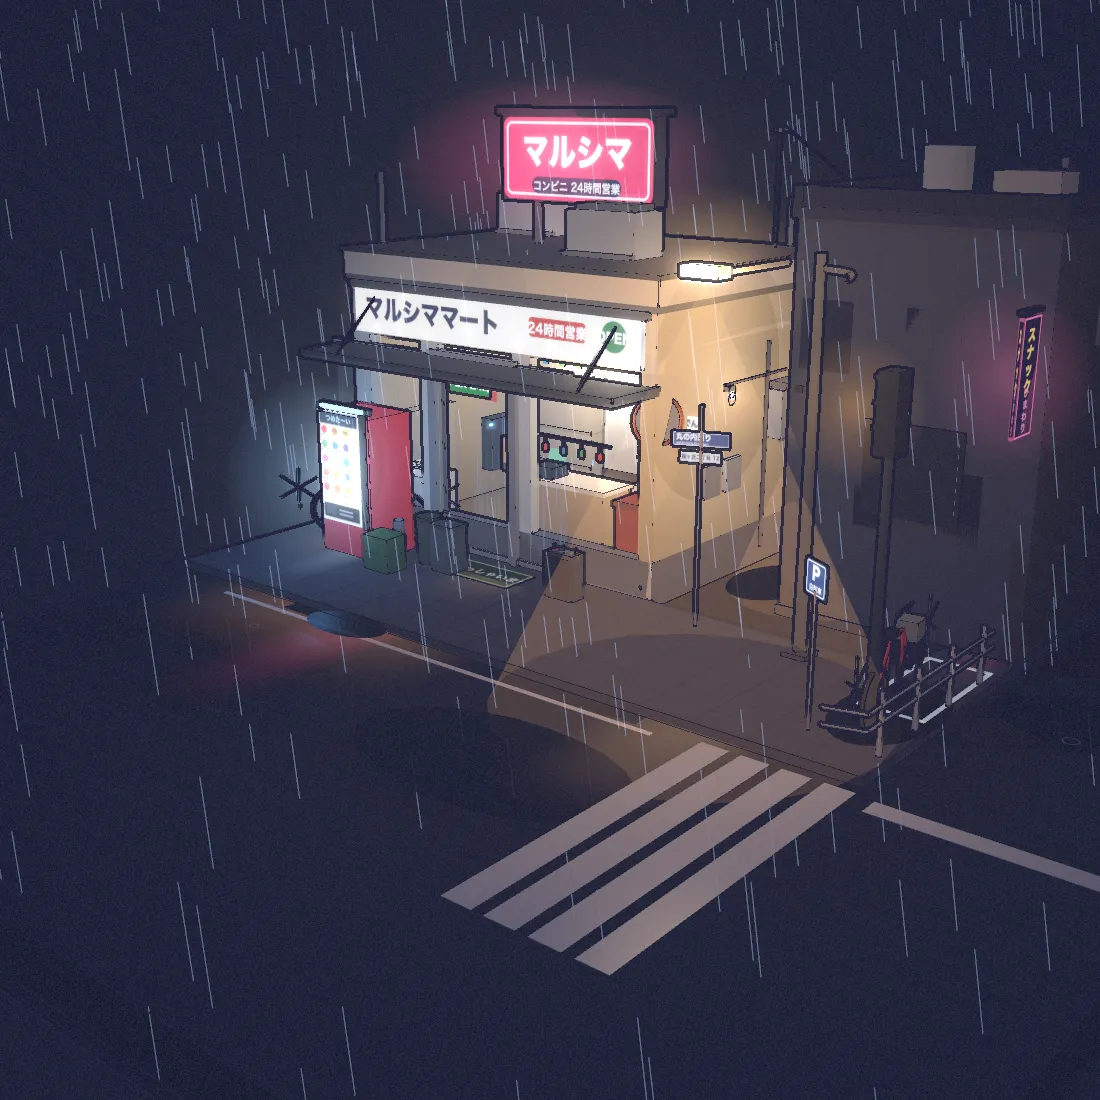
智谱线上这一份,大约跑了40分钟,比本地略快。招牌和雨夜的氛围比较明显,画面也更亮。它同样做过几轮修改,调整店内照明和一些细节。但问题也很明显,例如红绿灯的朝向和人行道的朝向明显有问题。
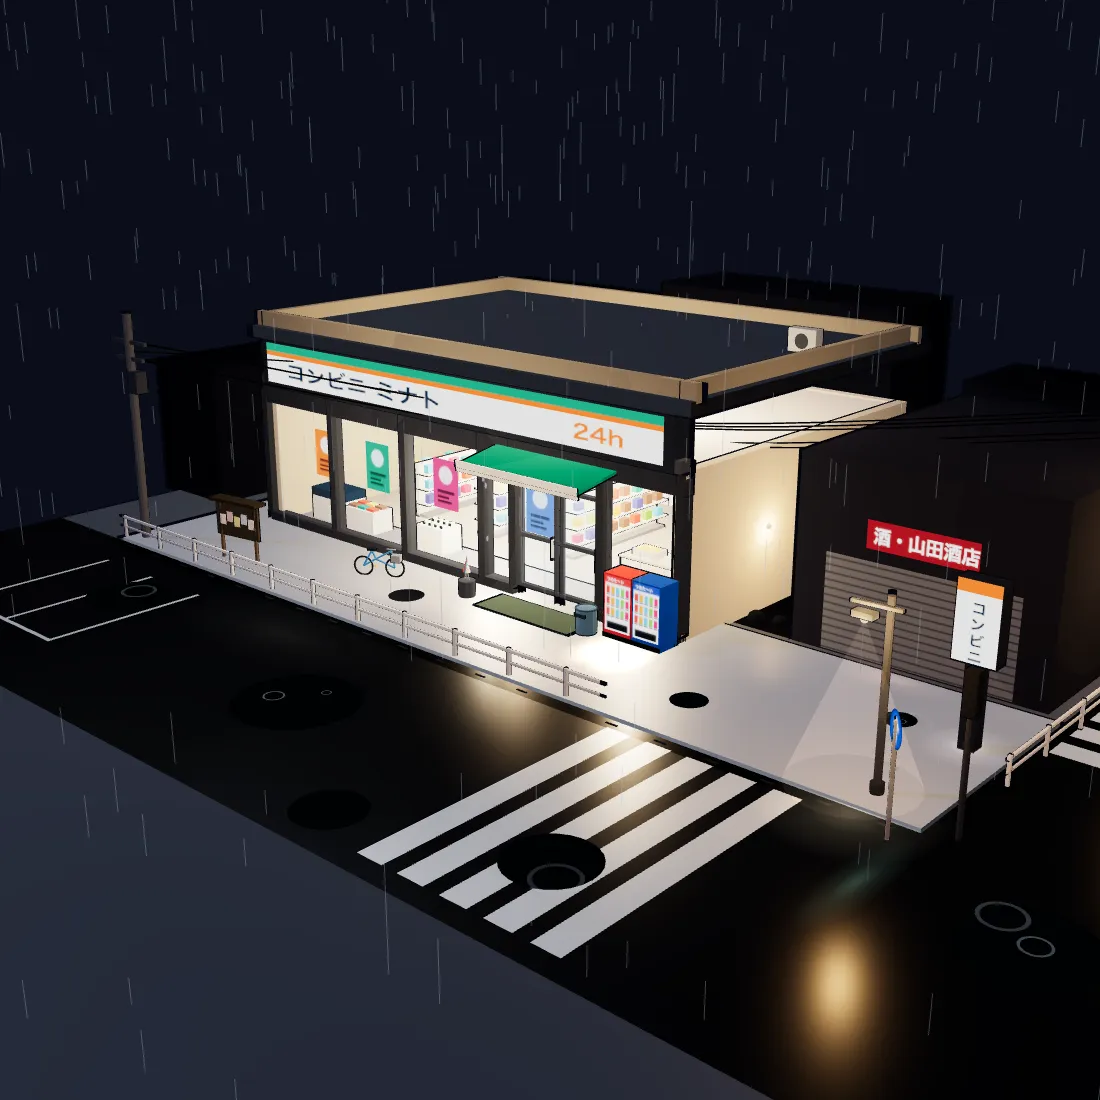
Kimi K3 这一轮出东西最快,用时20分钟不到,画面也利落,店面、旁边的建筑和路面反光都比较完整,但也和线上的GLM有一样的问题。
我真正想看的,是本地模型能不能进到开发工具里,把一件有点复杂的事做下去。慢一点没关系,遇到问题能查,前面做过的东西能接着改,最后留下的文件能打开、能继续使用,这就有实际价值了。
这次,本地这一份做到了。它还有不够利落的地方,但已经能承担这样的工作。至于三个画面哪个更喜欢,大家可以自己看看。
五、这东西到底能干什么
现在我本地这两个模型,已经能覆盖日常的绝大部分需求。讨论方案、写文本、整理资料、看图和页面,基本都在本地跑。
线上的模型我也还在用,毕竟有些场合它们确实更省心。但接下来我会琢磨着削减一部分,把重心慢慢挪到本地能做的那一摊上。
不过要说清楚,模型本身只是这件事的一半。更多时候,决定它能干多少活的,是模型外面那层。Harness 怎么搭、提示词怎么写、任务怎么拆,都算在里面。同样一个模型,套上不同的外壳,能做的事完全不是一个量级。
至于为什么非得用本地,图的是什么,那是另一篇的事了。今天先把这块积木摊开,说说我装了什么、怎么选的、看哪几样东西。
说到底就一句:能用起来,比跑分高重要得多。
感谢阅读。
哞小哞的杂货铺 · 第53篇 · 2026