折腾了这么多作图模型,我却没打开过 ComfyUI
杂货铺 · 第054篇
欢迎来到我的小铺,今天聊聊AI生图。
这是我的第二块重要积木,不跑模型时,我会切换成ComfyUI专属模式来跑图,当前大约跑了五六千张了吧。部署环境、加载模型、拼接工作流,再到把生成的图片分拣归档,全程几乎都是在命令行和 Agent 对话框里完成的。
直到交流本地AI如何生图,问我 ComfyUI 的工作流怎么配的、LoRA 有哪些等等,我愣了一下才反应过来:
前后测试了那么多模型,我好像压根不知道如何打开 ComfyUI 的前端界面。
一、算力到手,先装满再说
之前笔记本显存只有8G,那会跑图动不动的就爆显存,图片质量压根不敢超过512x512,现在一口气拉到了128G,还是2台,能尝试的开源模型多了很多,很容易就进入一种“集邮”的状态,看到什么新东西都想拉下来跑跑看。
Z-Image 很火,装一个;FLUX 表现扎实,必须得有;Krea2 很有特点,也留一份。更不用说开源社区里那些琳琅满目的画风 LoRA——水彩的、复古胶片的、特种材质的,别人展示的效果图一张比一张惊艳,就总想看看放进自己的机器里能出什么效果。
刚开始并没有太明确的规划。反正机器空着也是空着,既然能跑,就先跑起来。
那一阵子确实摸出了不少门道。不同模型的脾气各不相同:有的出图快但经不起放大,有的材质细腻但构图死板,有的则带着很强的个人风格。碰上想要的画面,往往不需要费尽心思写几百字的提示词,换个对路的模型,挂一个恰到好处的 LoRA,比怎么描述都管用。
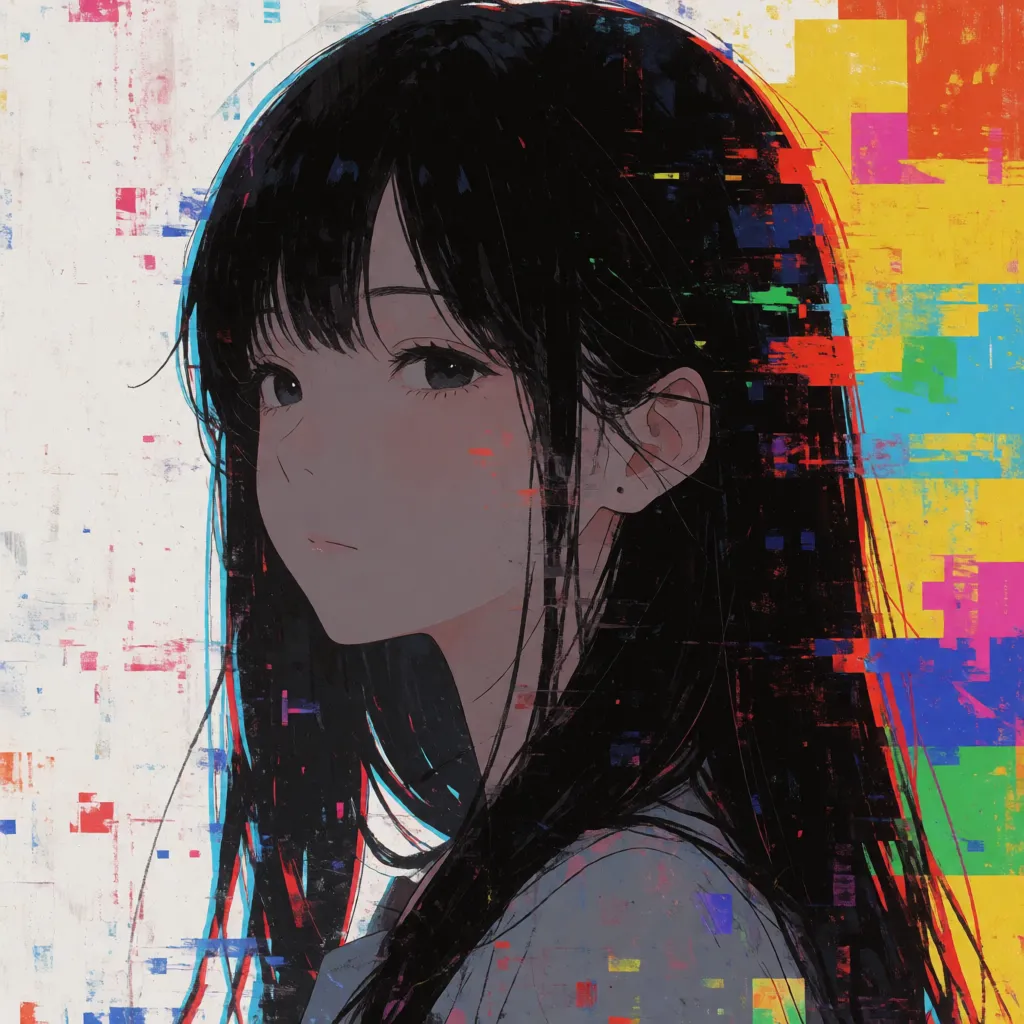
下面这几张,来自前面不同模型的尝试。
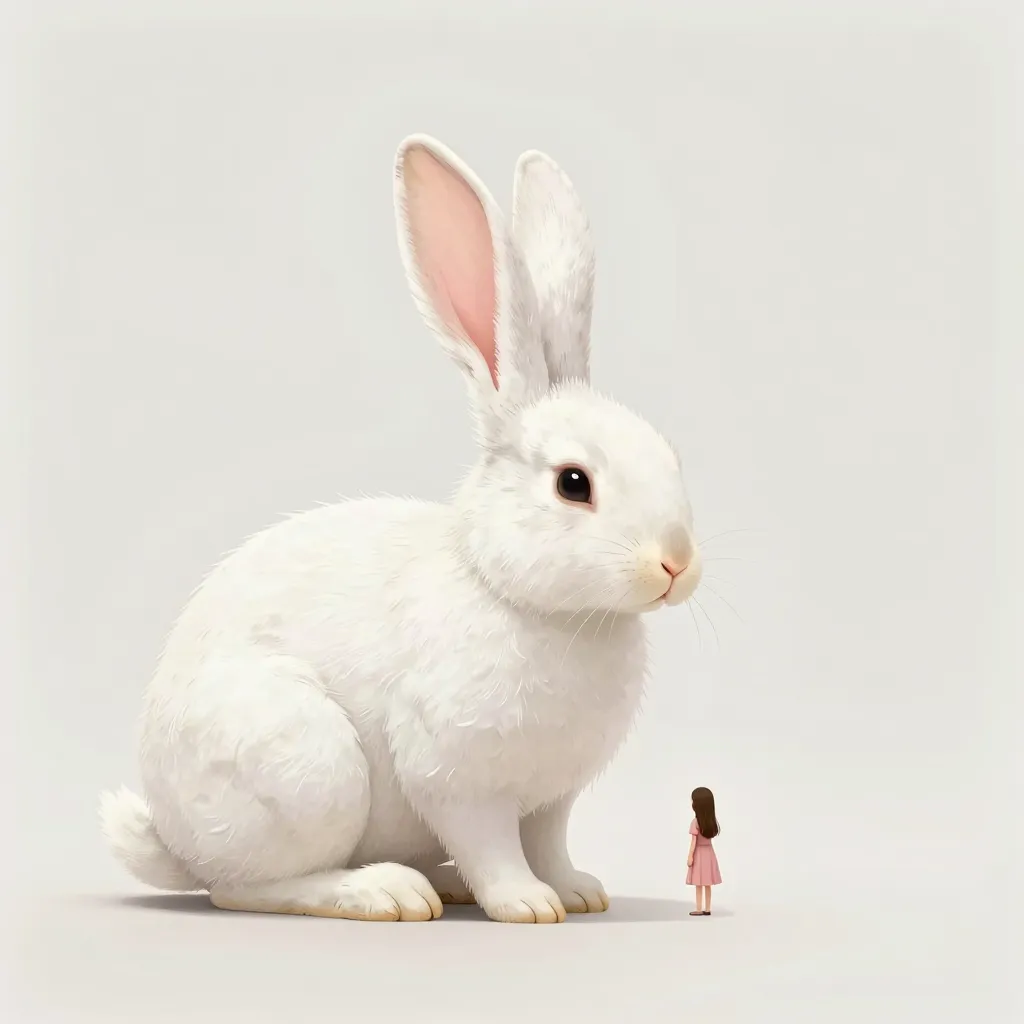
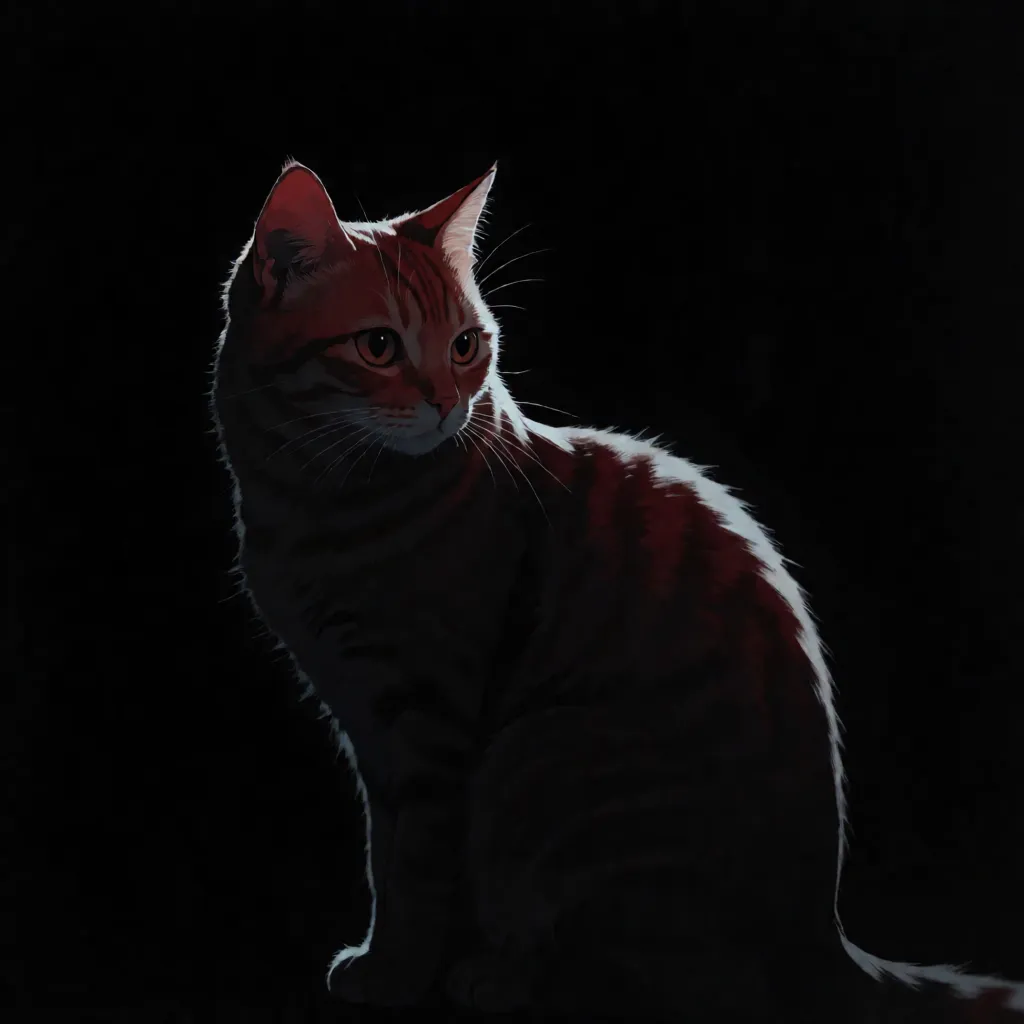
但这种“集邮”的新鲜感过去之后,我慢慢发现了一个问题:我准备的工具,远远超过了我的真实需求。
我既不是专业设计师,也不指望靠出图接单。大多数时候,我只是想在闲暇时把脑子里闪过的一个模糊想法具象化。我不需要为了交付客户去调到毫米级精度,更不需要每天追着几十个新节点的更新跑。
模型越装越多,硬盘越来越满,可我每天真正想表达的东西,并没有跟着膨胀。
二、当模型够用了,瓶颈变成了我自己的语言
直到换上Qwen-Image-2.1,我决定把“到处找新模型”的步子彻底收一收。
在综合素质上,它在我这套环境下表现得相当省心。日常的画面构图、不同媒介风格的模拟,甚至带文字的海报排版,它基本上都能给出非常稳定的可用结果。它当然也会翻车,也需要反复挑选,但我已经不再有那种“换下一个模型会不会更好”的焦虑了。
不过,够用归够用,出图速度并没有快到可以忽略。模型已经加载、机器没有其他任务的时候,我这里的快档大约十几到二十秒一张,慢档往往要一分钟到一分半,粗略相差三到六倍。画幅、配方和内容不同,耗时也会变化;第一次加载模型,还得另外等一会儿。真要临时赶一张图,这个等待是能感觉到的。
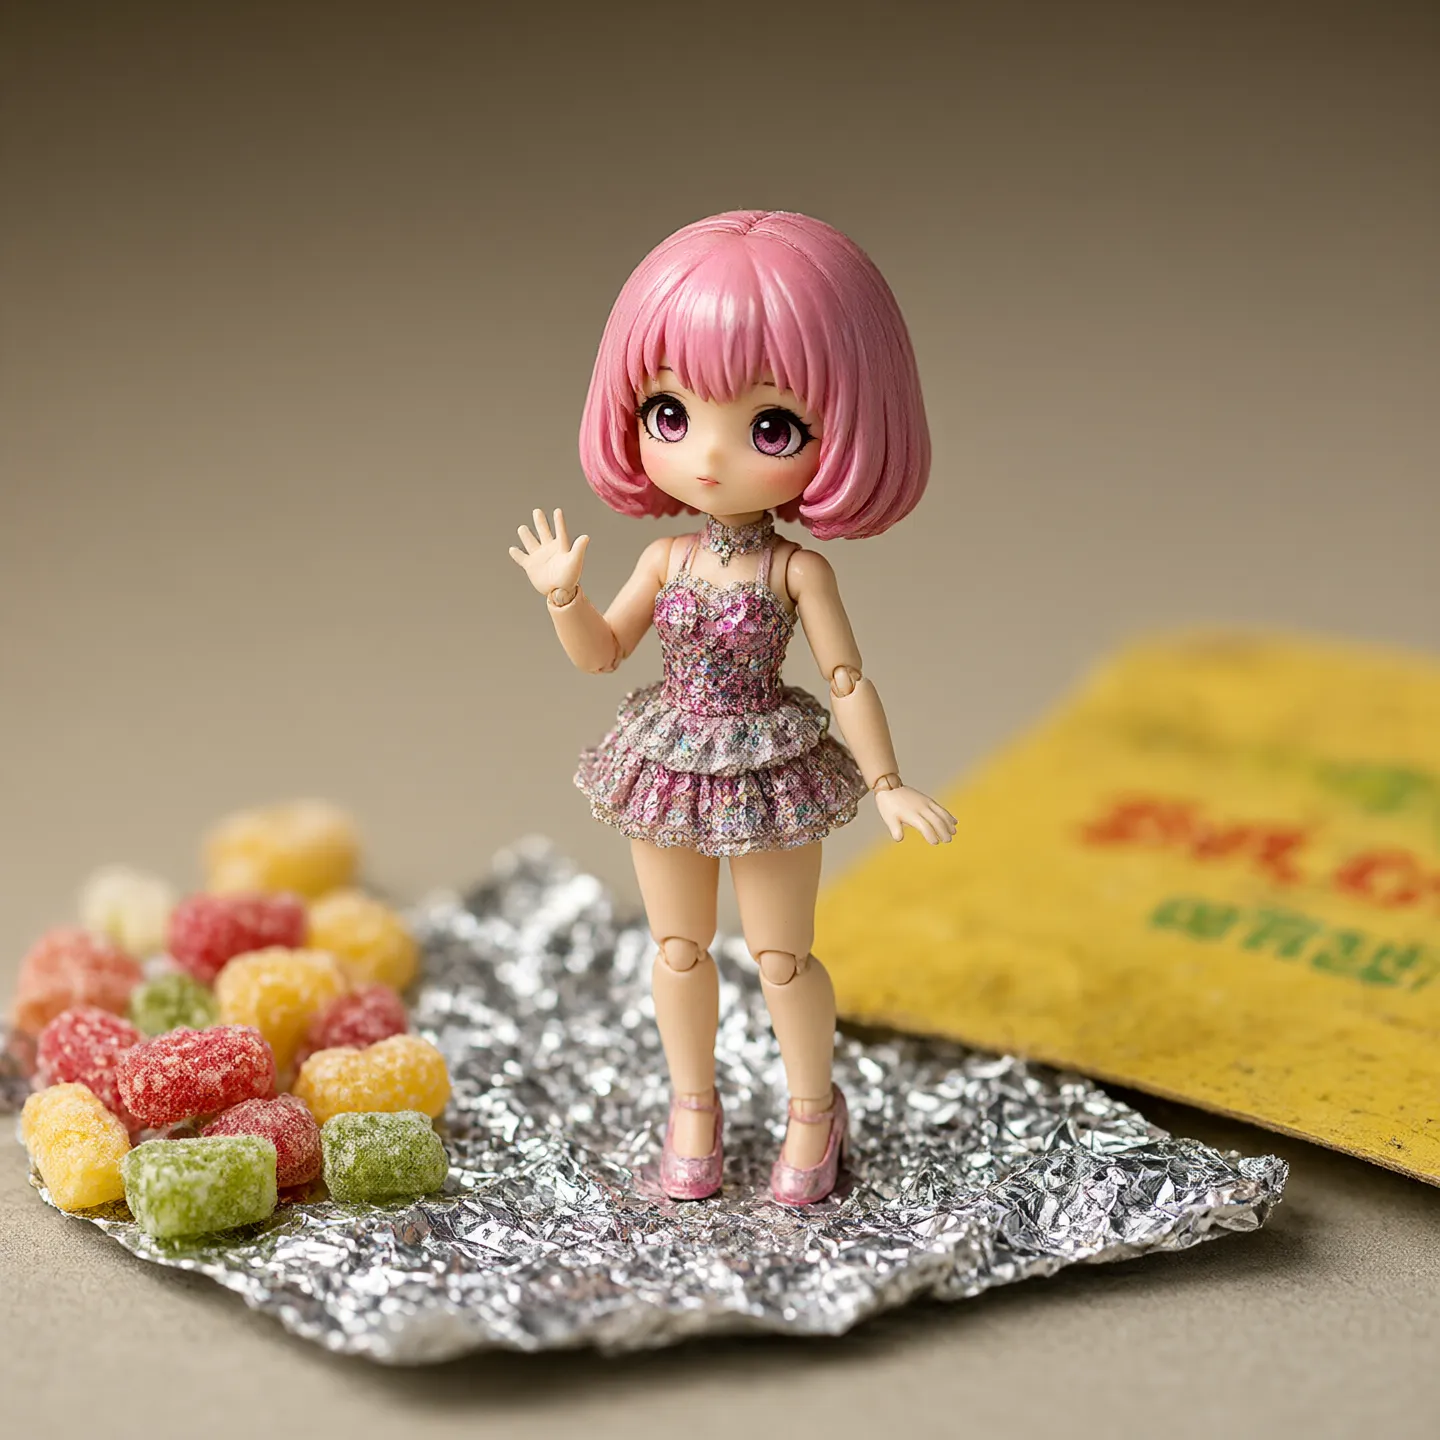
用行业的话说,这叫“边际收益递减”;对我个人来说,就是工具已经跑到了我的需求前面。
可当这套环境已经基本能满足我的日常需求之后,另一个更尴尬的问题浮了上来:
我到底想画什么?
很多时候,我脑子里只有一个特别干瘪的画面:一条街、一间屋子、或者黄昏时的一扇窗。提示词里堆砌着“高质量”、“氛围感”、“艺术感”,这些词对于现代模型来说早就是车轱辘废话。等它画完,点开看,画面的完成度可能不错,我却还是觉得那并不是心里真正想要的那一张。
更残酷的现实是:我心里想要的那张图到底长什么样,我自己也根本说不清楚。
看见优秀的摄影或画作,我能直觉地感受到喜欢。但喜欢的究竟是光影的冷暖反差,是画面留白的疏密,还是某种材质粗糙的质感?一旦脱离原图,换个场景,我就失去了描述它的能力。
这种人类语言的匮乏和审美的模糊,不是多下载两百个 G 的模型或打十几个 LoRA 补丁就能解决的。
三、把算力当成“审美的撞击机”
想弄清楚自己到底喜欢什么,光靠坐在屏幕前干想是想不明白的。人的眼睛和审美很现实,必须看过足够多的样本,在大规模的对比中,喜好才会逐渐浮现。
所以这件事绕了一大圈,还是得回到“出图”上。只不过,这回不是漫无目的地测模型,而是带着探索审美的目的在跑。
我的想法其实很朴素:反正算力摆在这里,机器闲着也是闲着,不跑白不跑。
单张出图慢一点,放到这种用法里,反而没有那么要紧。我不需要一直坐在旁边等,也不用每多试一张,就心疼一次按张计费的成本。机器已经买了,电费当然还有,但利用闲下来的时间多跑几轮,我更愿意把注意力放在能不能找到有意思的东西上。
不着急的时候,晚上把提示词和任务安排好,让机器慢慢跑,我去睡觉。按一分钟一张粗算,几百张就是几个小时;有足够的空闲窗口、任务也顺利的话,睡一觉起来,一批几百张图就已经在画廊里等着我了。两台机器都空闲时,还可以分别承担不同的任务。
所以我这里的“快”,更多是不用占着我的时间。我把要求交代好,过一段时间再来看;生成花了多久,和我需要守着多久,是两回事。
既然Qwen-Image-2.1已经能支撑起多维度的表达,我就让它去帮我撞击可能性。同一组主题,我可以让它发散出不同的打光方式、不同的构图透视、不同甚至互相矛盾的材质组合。我想看看,那些我用语言描述不出来的东西,机器能不能在随机探索中替我撞出一些火花。
在这个环节里,Agent 的价值才真正凸显出来:
- 它去翻阅相关的风格资料,把我的一个模糊念头拆解成几个维度的提示词矩阵;
- 它调用本地模型,批量跑出几十上百张差异化的尝试;
- 图片生成后直接落进画廊,我不需要关心中间的中间件怎么调度,我只需要坐下来看图。
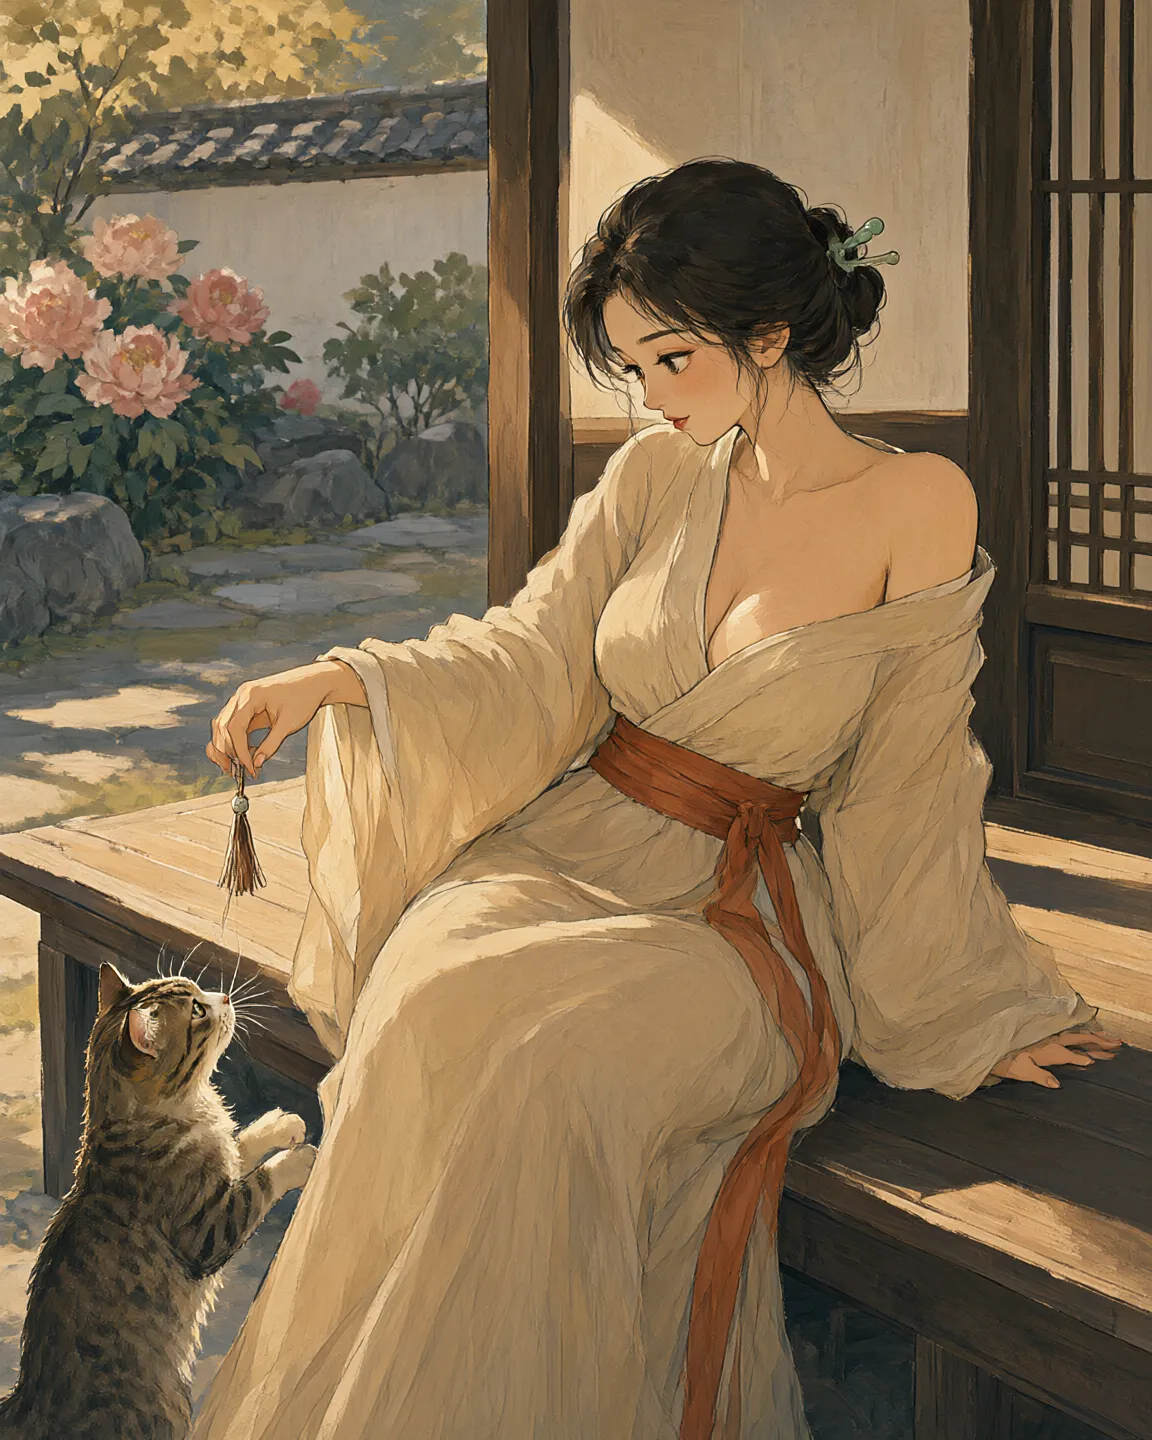
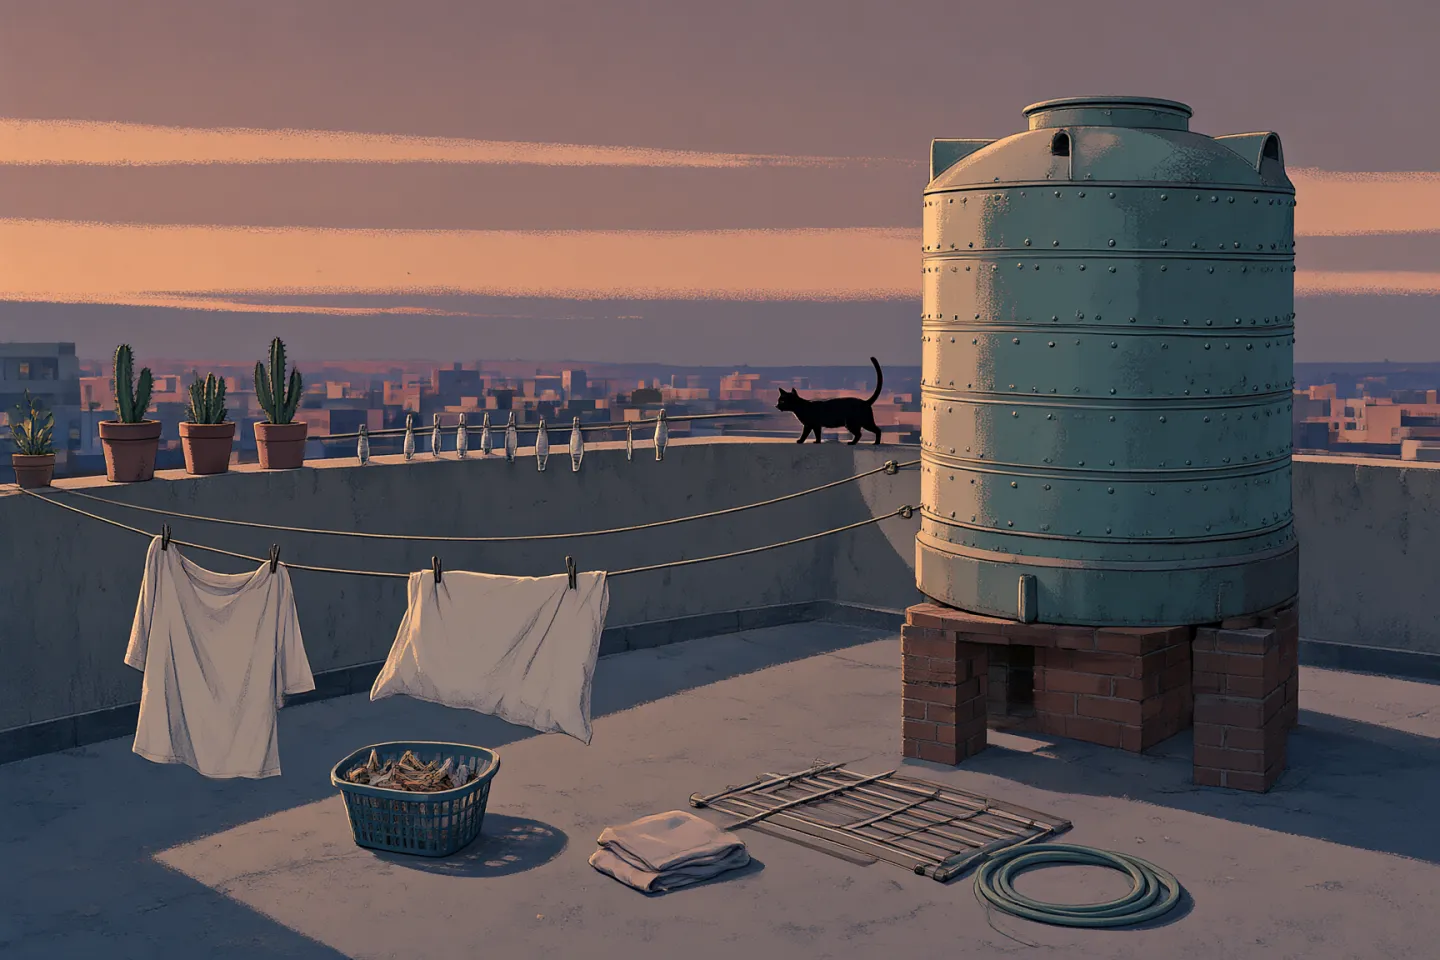
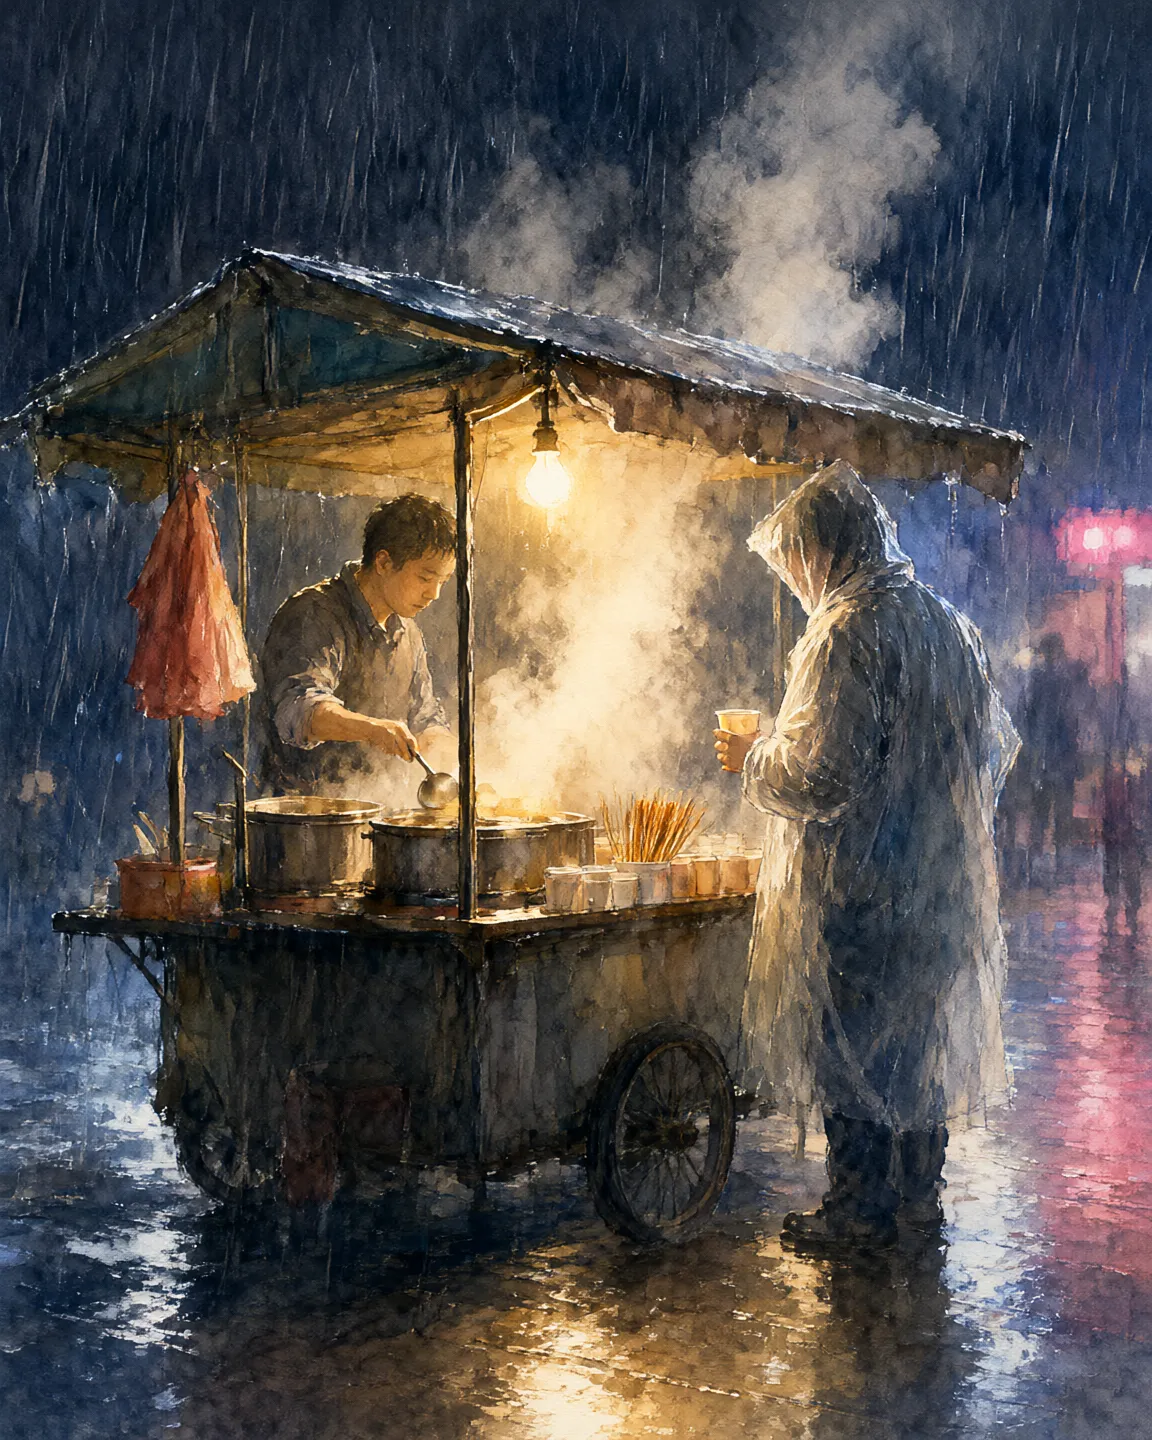
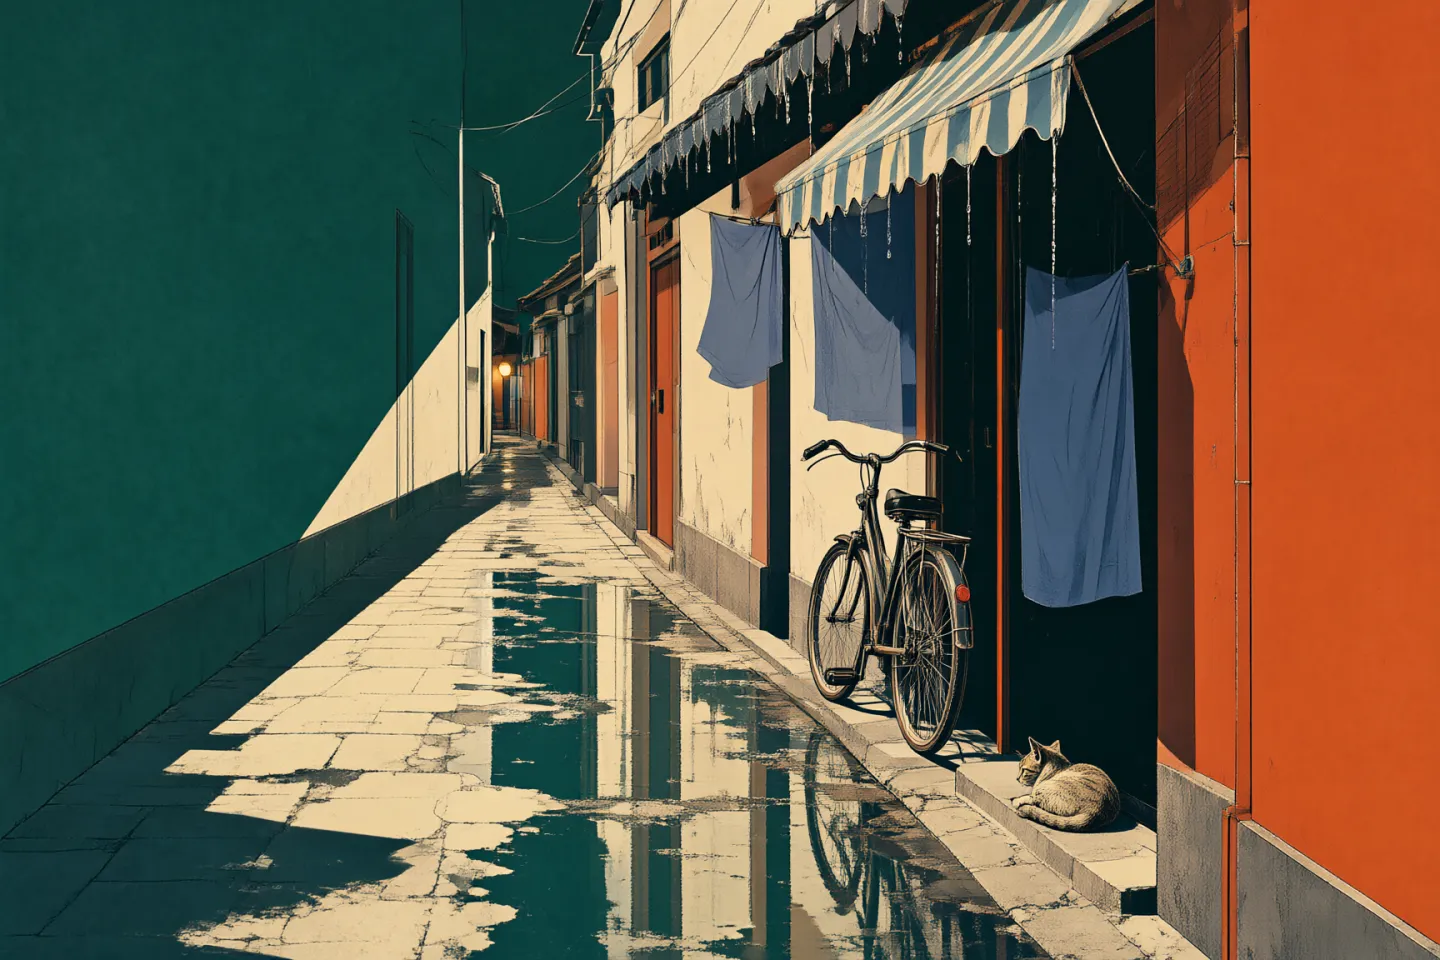
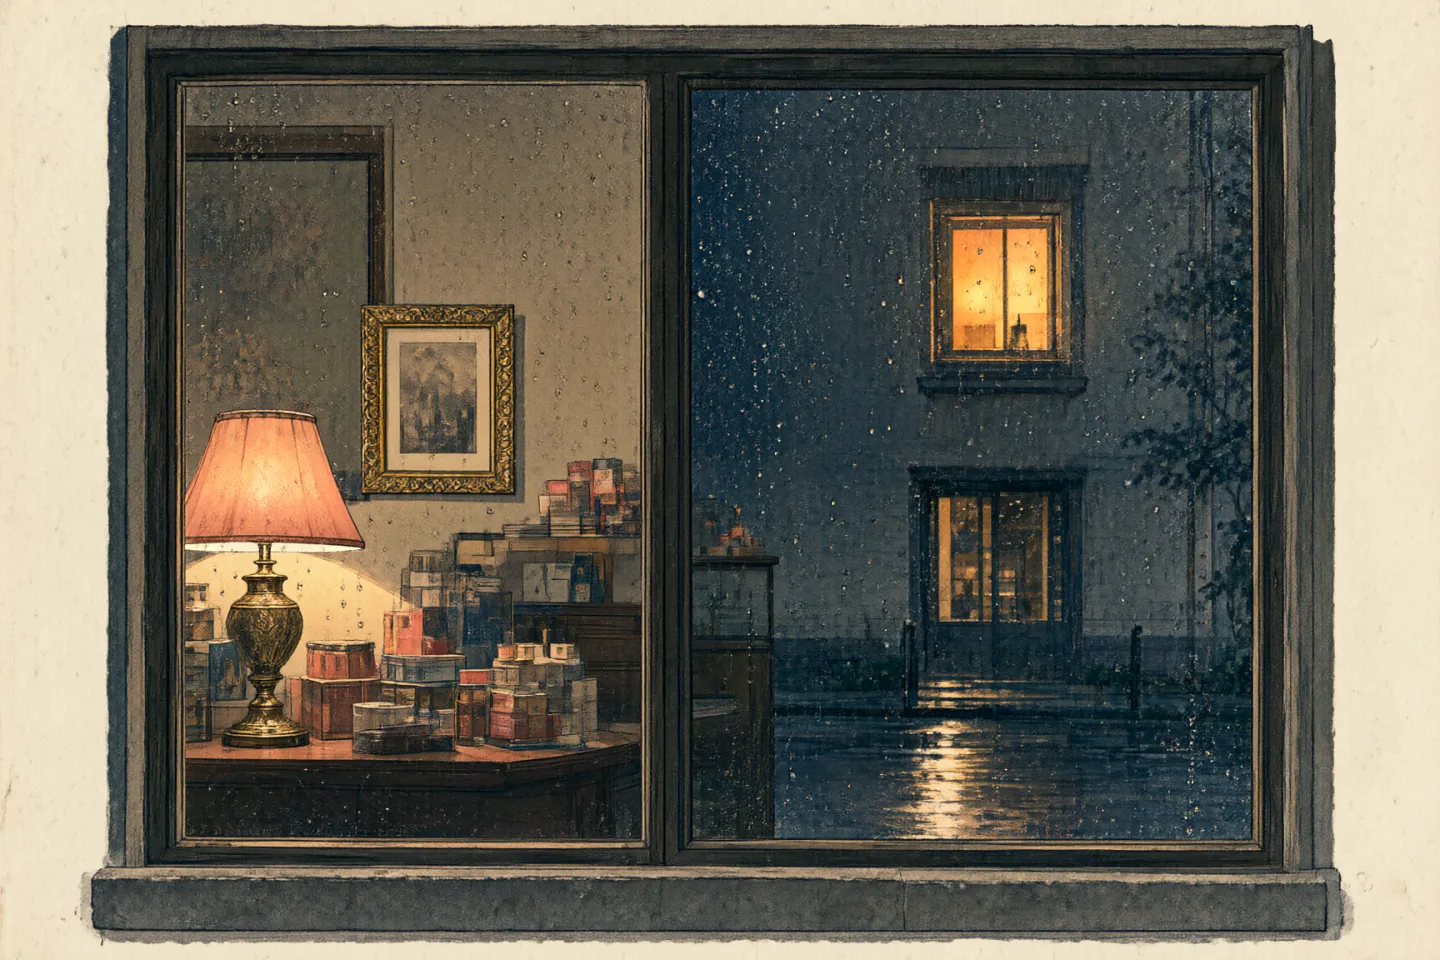
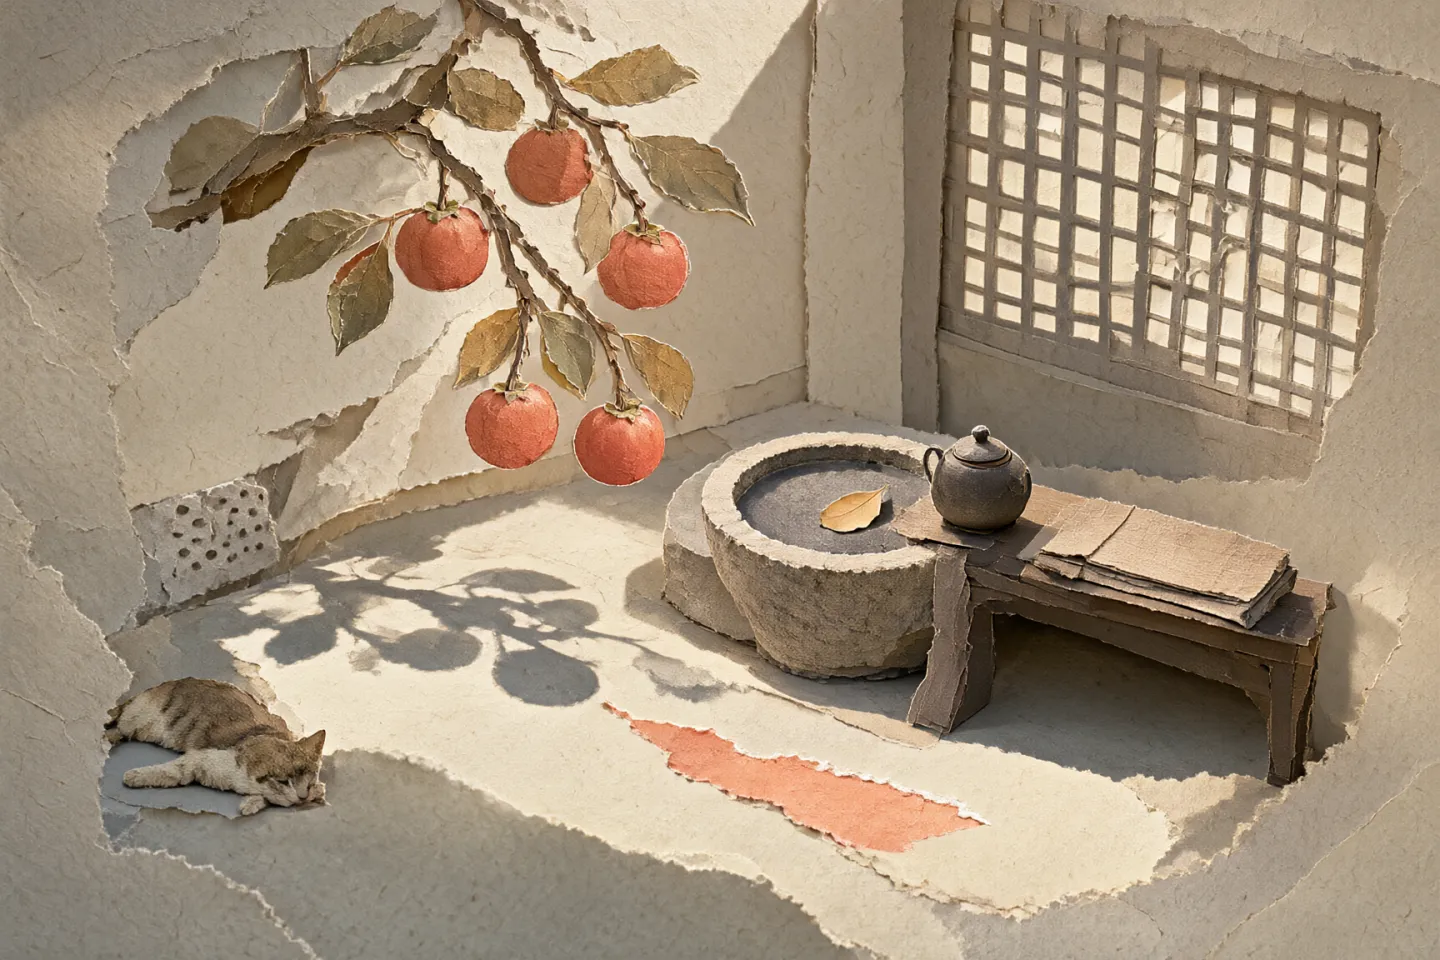
下面是从不同轮次、不同模型的探索里挑出的几组图片。它们是我想留下来的素材,并不是一组同条件的模型评测。
人物、笔触和材料的尝试。
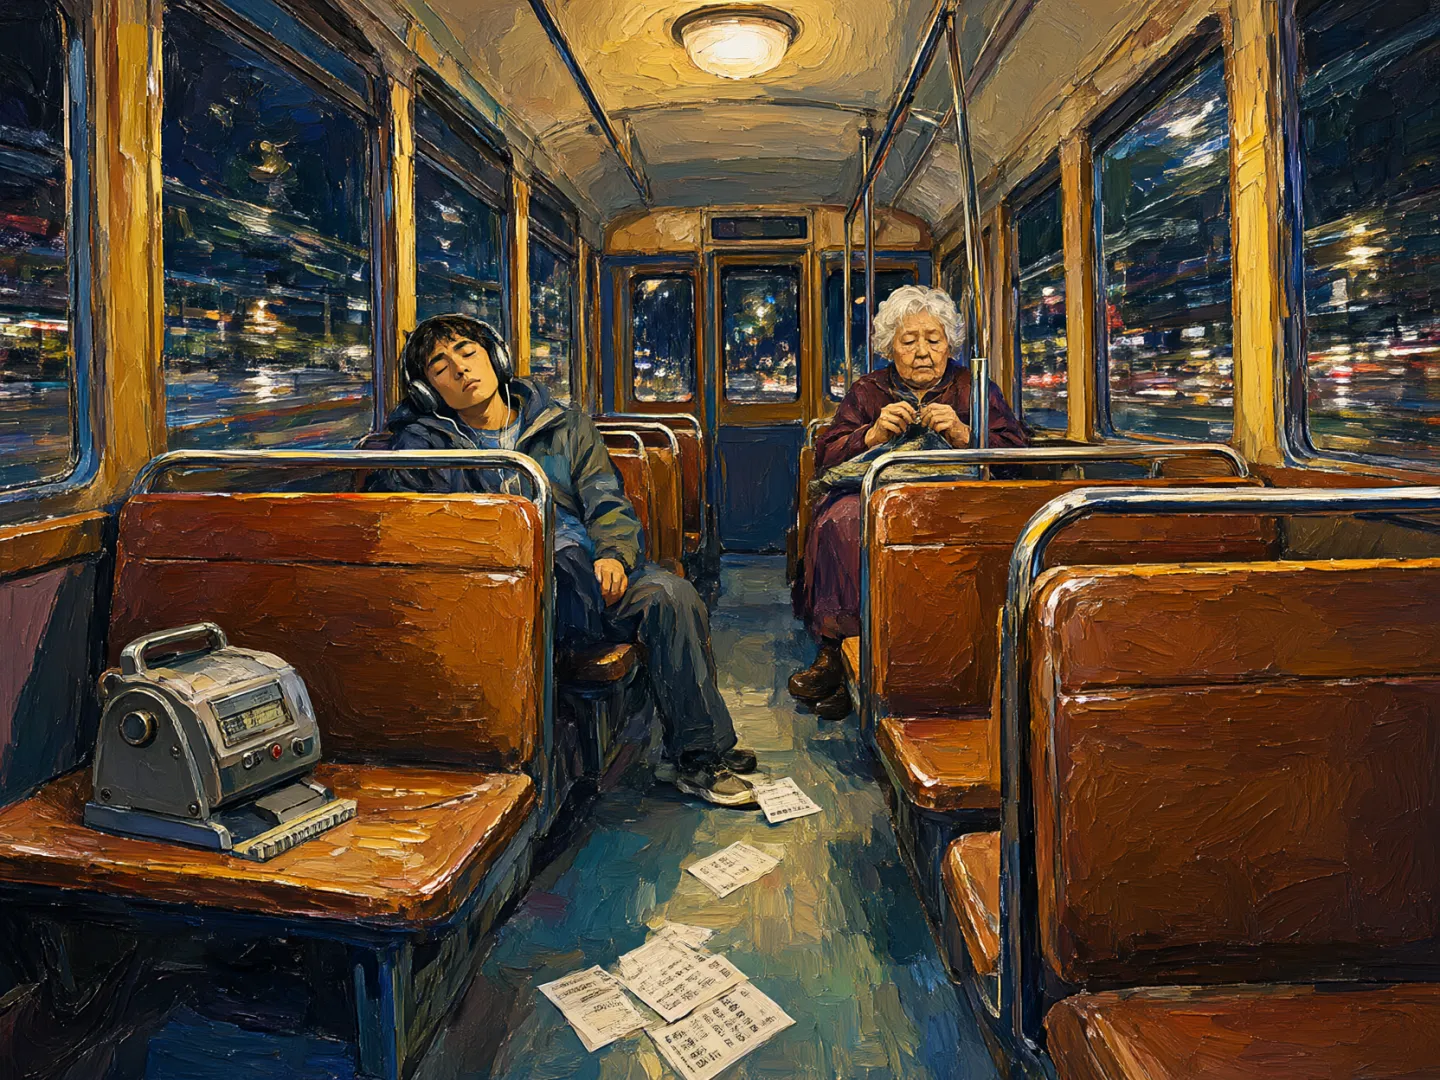
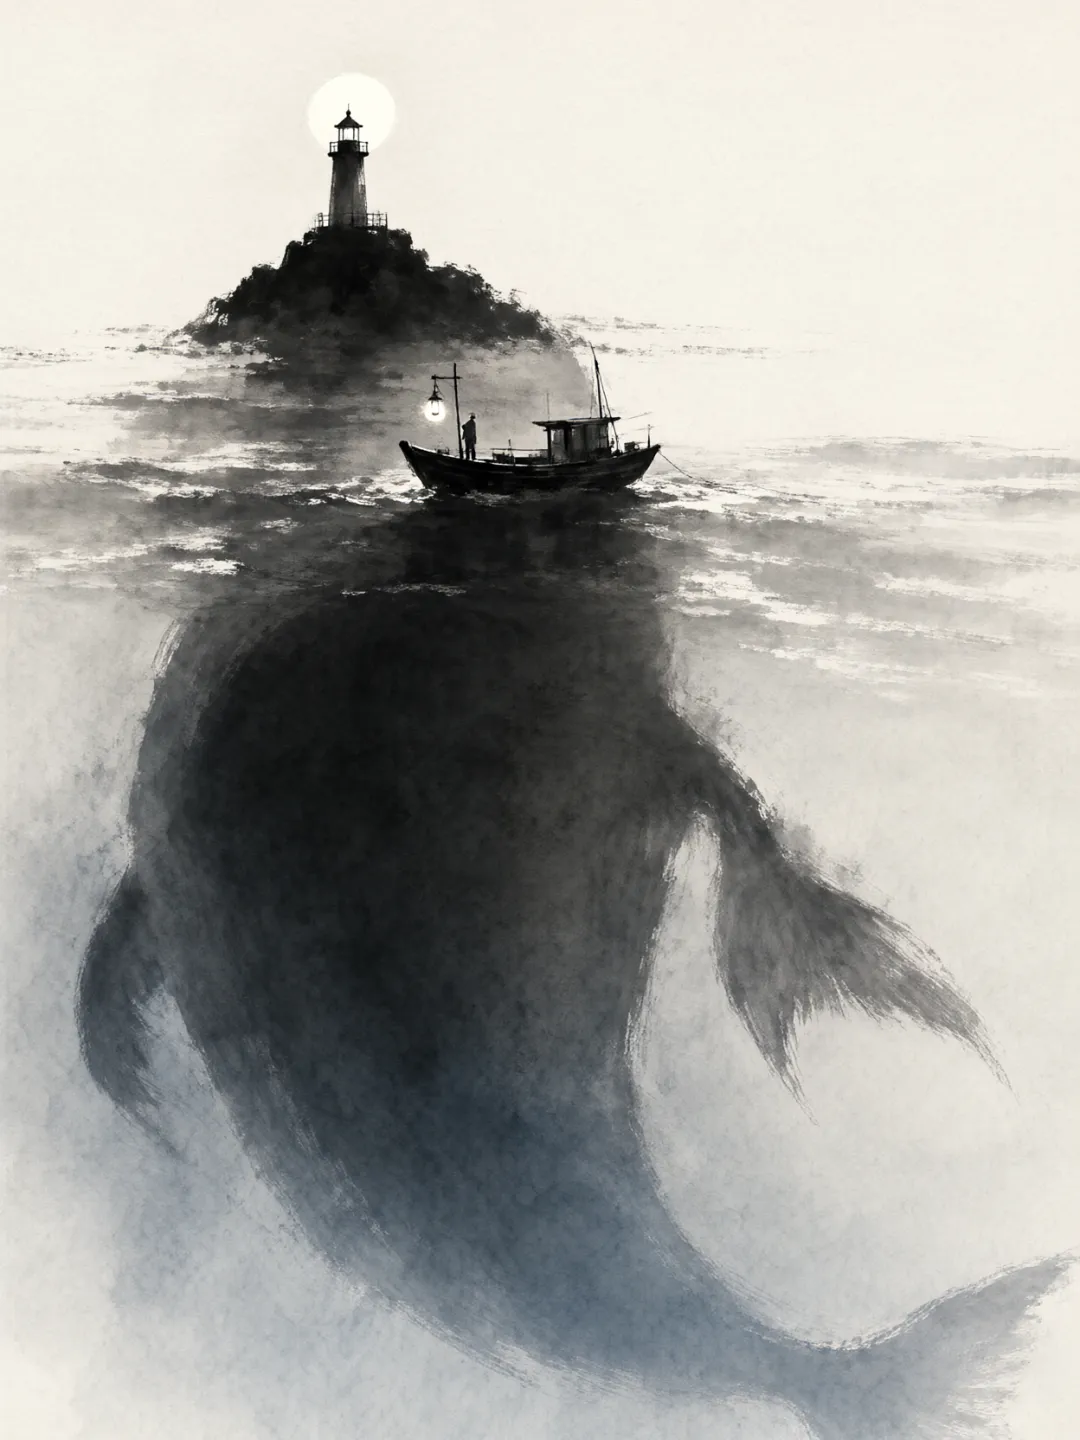
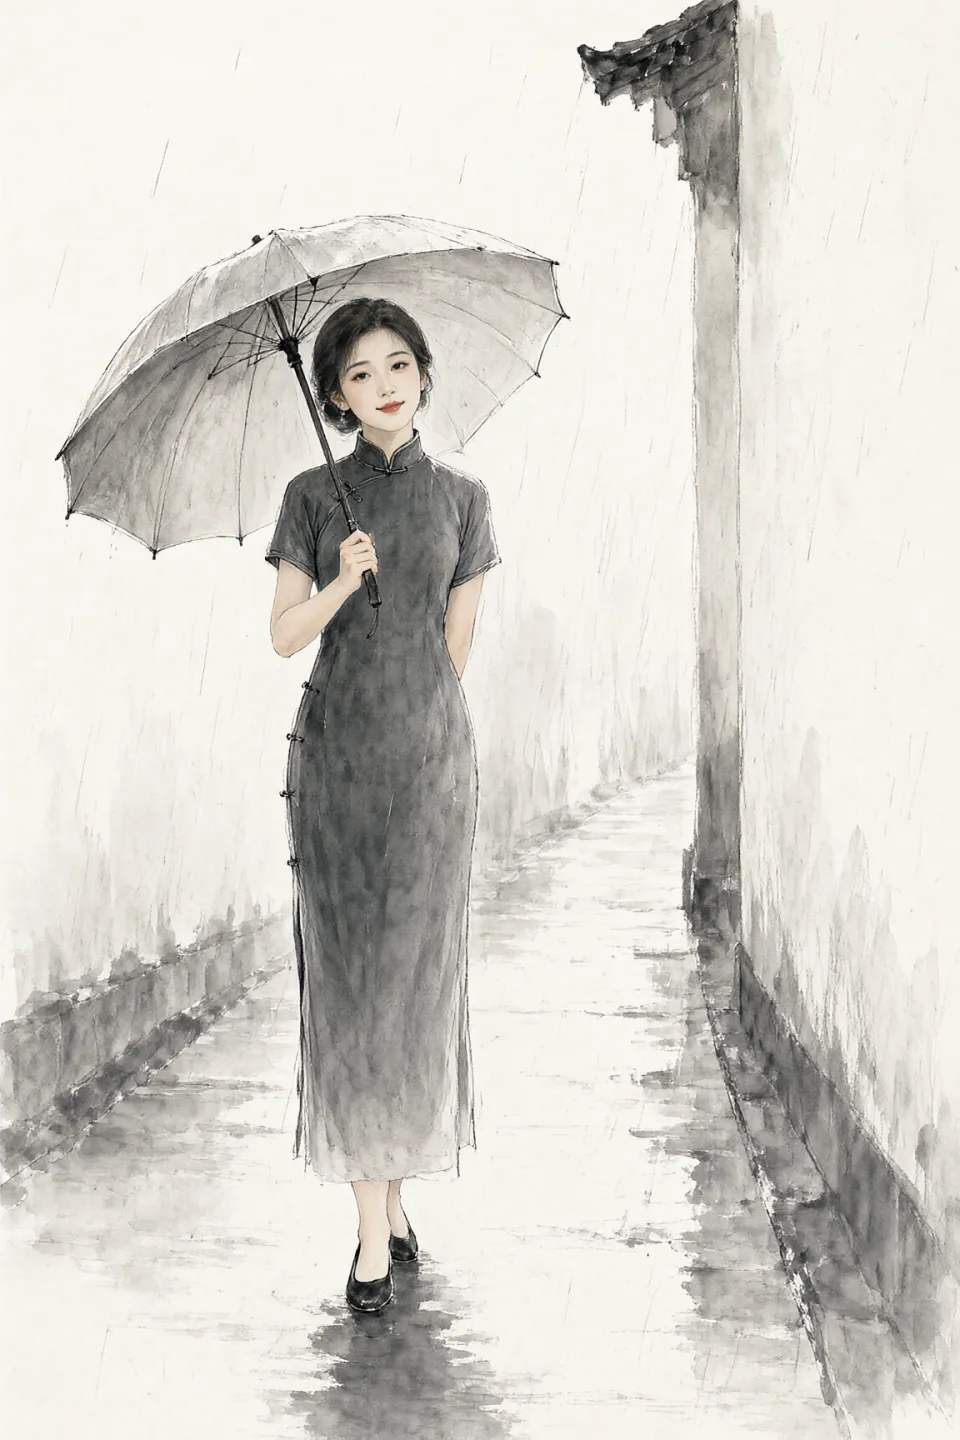
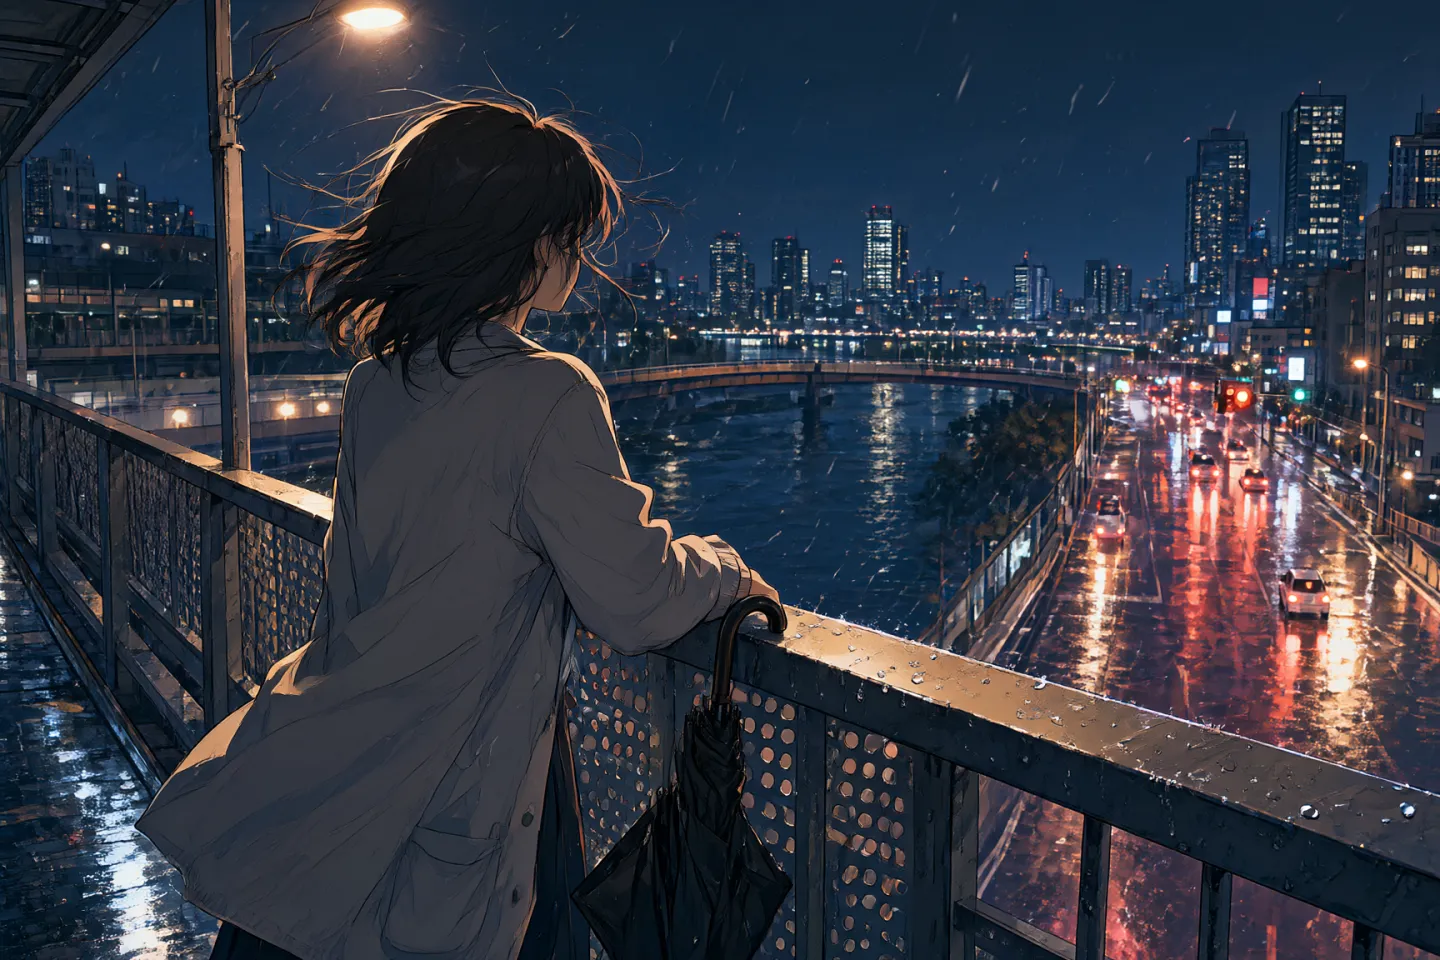
也有城市里的小场景。水塔、便利店、街边小车和窗户,都能成为画面的中心。
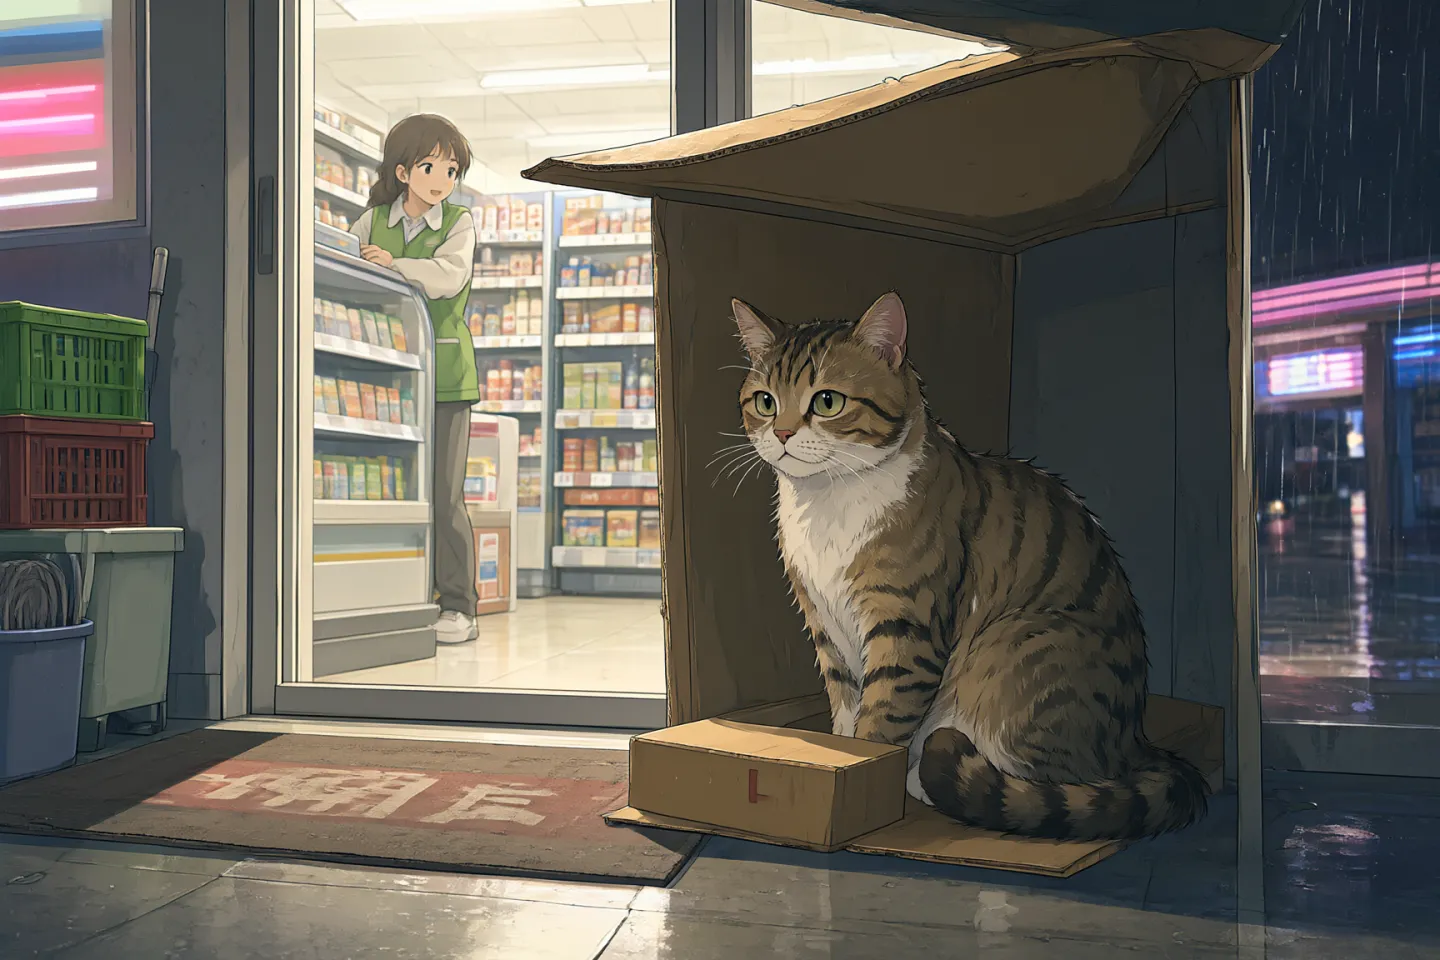
再往另一头试,画面也可以少一点。留白、斜光和小小的空间,同样值得看。
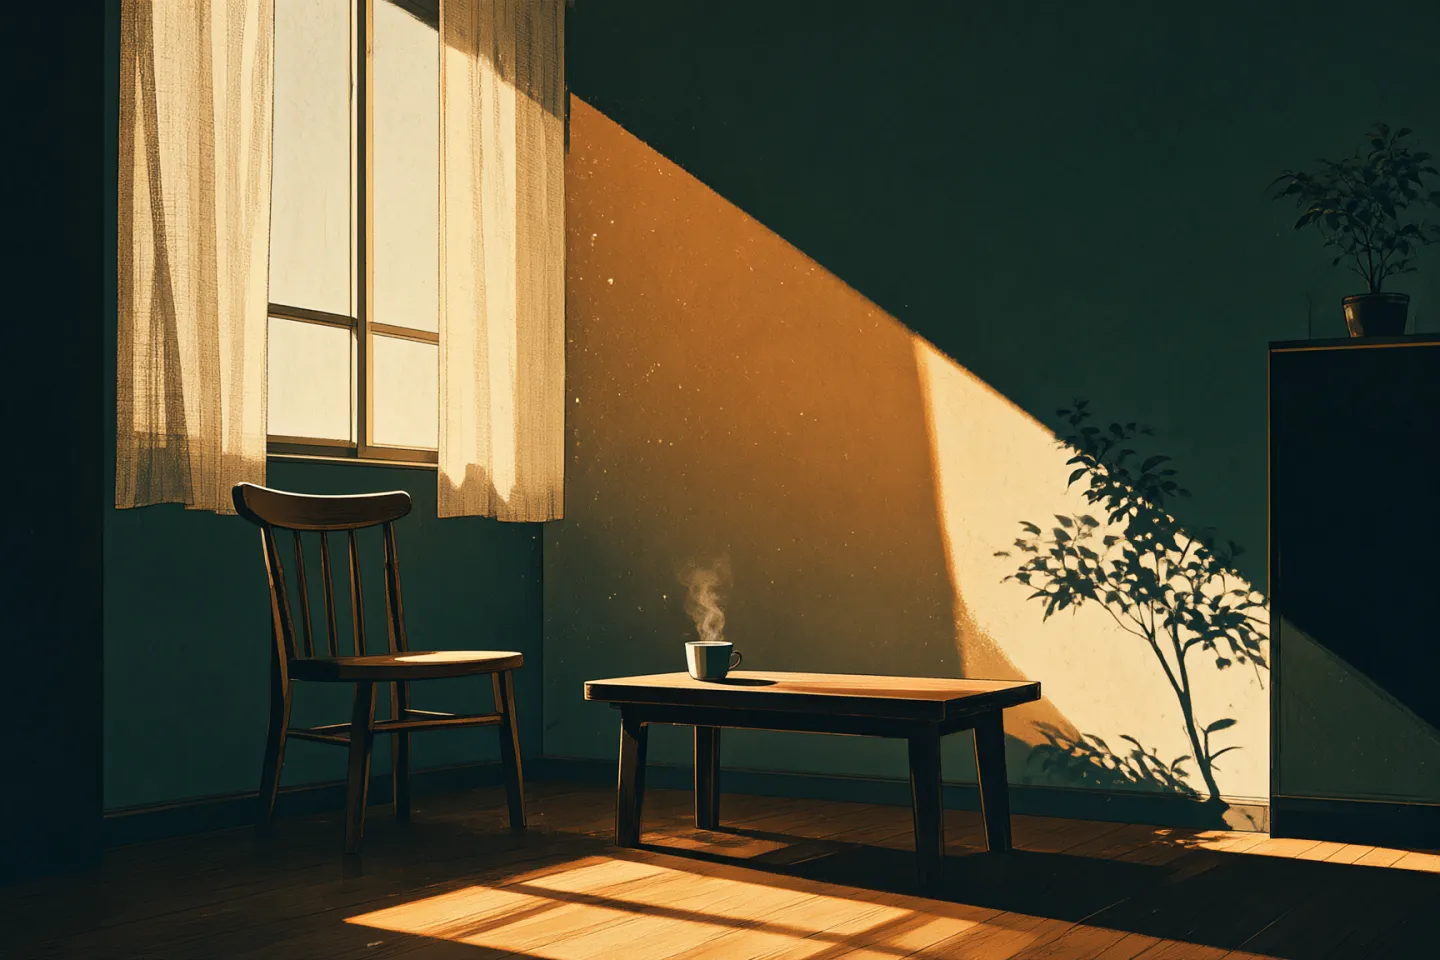
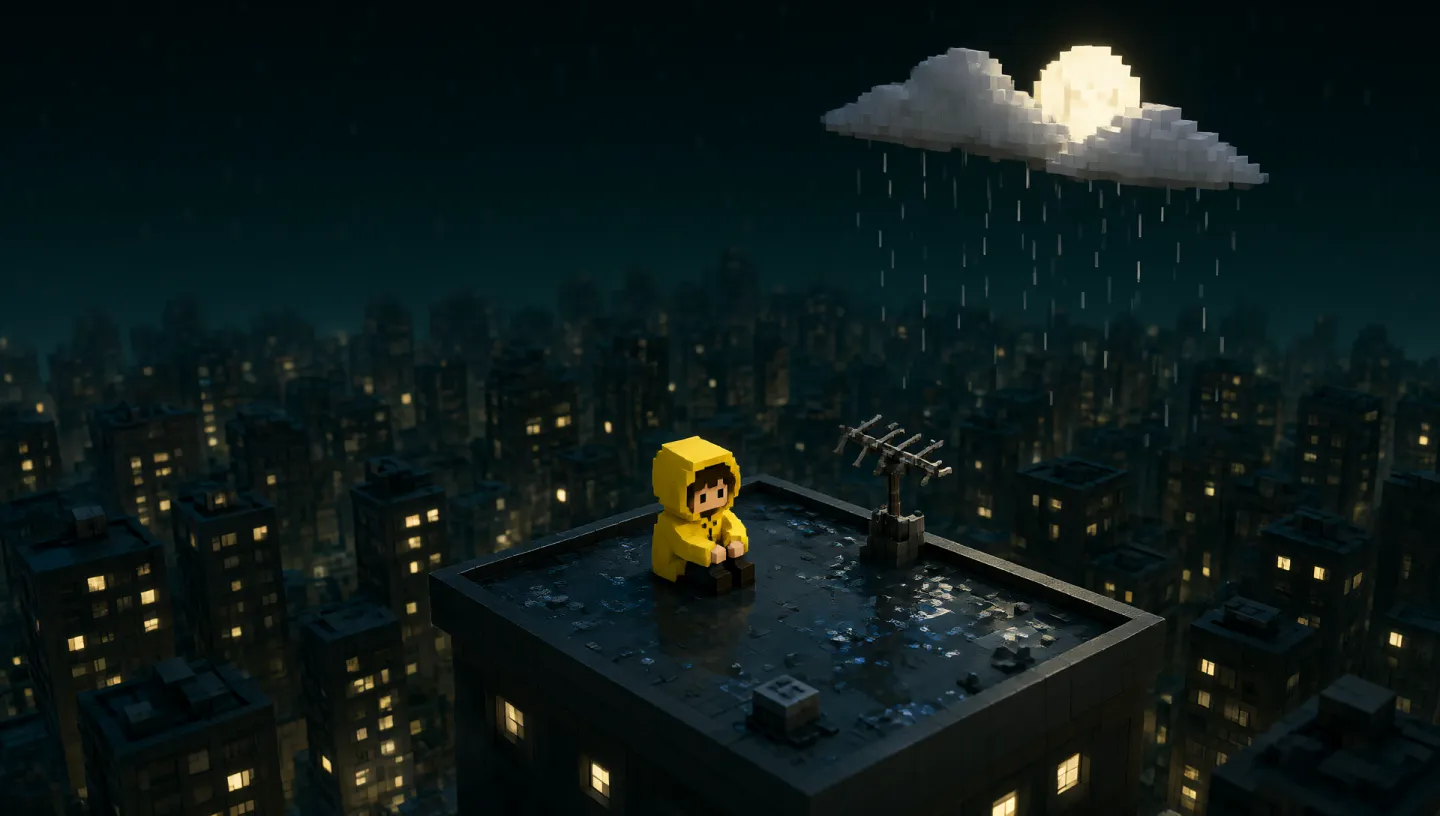
有的图第一眼惊艳,看两秒就觉得俗气;有的图虽然主体崩了,但角落里某种颜色的搭配、或者阴影处理的质感,却让我觉得“对,这就是我要的感觉”。
我把这些细微的感受反馈给 Agent,让它沉淀成某种特定的审美偏好,下一轮测试时继续沿着这个微小的切口往下挖。算力在这里不是用来追求“单张出奇迹”的,它更像是一个不知疲倦的草稿机,帮我在无限的可能性里做减法。
四、为什么 ComfyUI 必须“退居幕后”
看到这里,大概就能明白我为什么从不打开 ComfyUI 了。
不可否认,ComfyUI 是目前开源社区里最强、最灵活的生成调度器。但它的本质是一套工程逻辑:节点怎么连、依赖怎么装、显存怎么优化、参数怎么传。
如果我每产生一个微小的画图念头,都要先打开网页,面对密密麻麻像蜘蛛网一样的连接线,花半个小时去排查报错、微调两个浮点数权重,那我最初那点探索的兴致,大概率在连线的第三分钟就消耗殆尽了。
在我这套体系里,ComfyUI 是一套极好的无头(Headless)后端,但我坚决不要把它当成前端交互。
调参、查文档、找社区里验证过的最佳工作流 JSON、把任务丢进 DGX 执行……这些本就是 Agent 最擅长处理的结构化脏活。而作为人,我最不可替代、也最宝贵的能力,其实是直觉、挑剔和做决定。
我告诉 Agent 想要的感觉,它去调遣背后的工作流和算力;出图之后,我负责看,负责挑,负责说“这里不对”。
这不是说参数不重要,而是人机协作的分工变了。将来如果真有一天,我的审美探索细化到了某种极致,现有的一切通用配方都满足不了,非得亲自去改某个底层节点的采样数学逻辑,那我自然会点开它。但在那一天到来之前,我更享受现在的状态。
从最初盲目装模型的兴奋,到收拢到千问时的平静,再到如今借助 Agent 去寻找自己的审美边界,折腾的重心变了,但乐趣一点没少。
机器还在后台安静地跑着,我继续喝着茶看图。希望下一批落进画廊里的图,能有一张让我多停下来看一会儿。
感谢阅读。
哞小哞的杂货铺 · 第54篇 · 2026